 域财网
机器人“大脑”算力冲向1500 TOPS,为什么身体还在等50毫秒?瑞迅科技RK3588/3576/3568双芯方案解析
2026年的机器人行业,算力数字正在以极快的速度刷新。面向具身智能的“大脑”控制器已经做到1500 TOPS量级,原生兼容VLA和世界模型,目标是为通用机器人提供高性能的智能计算中枢。单从纸面参数看,机器人的“思考能力”正在逼近一个此前难以想象的量级。
但机器人的物理身体并不按算力参数运行。一台人形机器人在物理世界中的闭环控制,要求动作更新频率至少达到20Hz,对应50毫秒的端到端时延;低于这个频率,机器人在重复定位精度出现偏差时无法及时修正,卡顿和任务失败的概率会显著上升。底层关节的力矩控制则要求更高的频率——工业机械臂和足式机器人的伺服回路通常运行在500Hz至1kHz,即每1至2毫秒就要消费一次新的力矩指令。
而当前VLA模型的单次推理延迟,普遍在50至200毫秒之间,部分扩散策略甚至需要数百毫秒才能生成一个新的动作块。三个时间尺度摆在一起,矛盾非常直接:大脑的“思考”以几十到几百毫秒为周期,身体的“执行”却以毫秒为周期在运转。如果让身体停下来等大脑想清楚,机器人的动作就会从连续轨迹退化为断续的“想一下、动一下”;如果让身体不等大脑,那么执行的动作就是基于过时的观测计算出来的,在动态环境中会表现为动作滞后、空间错位,甚至关节抖动。
单芯片架构的隐性代价:推理与控制在争抢同一条时间轴
面对这一矛盾,一种直觉的思路是“把推理做得更快”。但问题并不完全出在推理速度上,而出在推理任务与控制任务在时间轴上的资源争抢。
当VLA推理和关节控制运行在同一颗SoC的同一套调度体系中时,推理任务的长时占用会直接拉长控制线程的唤醒间隔。VLA骨干网络在闭环控制中处于“控制关键路径”上:它在计算的同时,机器人仍在运动,每个被执行的动作所依据的观测都在变得过时。单芯片方案中,推理队列的排队时间随负载波动,控制线程的时序确定性被推理任务的突发算力需求侵蚀。结果是,即便芯片标称算力很高,控制环仍然会在某些周期被推理任务“挤掉”,表现为关节指令的延迟跳变。
更深一层的问题在于,VLA推理本身是一个计算密集与内存密集交替的过程,而关节控制是确定性、低延迟、高频的硬实时任务。两类任务对硬件资源的使用模式完全不同,却要在同一套调度器和同一块内存带宽上竞争。瑞迅科技在机器人主控方案中面对的正是这一层工程现实:单芯片的算力堆叠可以提升推理吞吐,但无法自动解决推理与控制之间的时间隔离问题。
双芯分离:让“慢思考”和“快控制”各走各的时间轴
行业正在形成的共识是“控制/推理频率解耦”:慢模型(VLA、规划)以低频产出动作意图,快控制器(PD、WBC、阻抗控制)以高频执行,避免把推理延迟写进力矩周期。异步架构的实测数据也印证了这条路径的有效性:在推理延迟按模拟时间计费的基准上,解耦后的系统从0.8B到8B骨干网络均能保持20Hz的控制速率,而同步流水线的控制速率会从9.7Hz跌至4.1Hz。
瑞迅科技的RK3588/RK3576 + RK182X双芯协同方案,在硬件层面承接的正是这一解耦逻辑。RK3588或RK3576作为主控SoC,专职负责运动控制、多传感器融合与系统调度;RK182X端侧AI协处理器通过PCIe高速互联专职承担AI推理,两者各司其职、互不抢占资源。
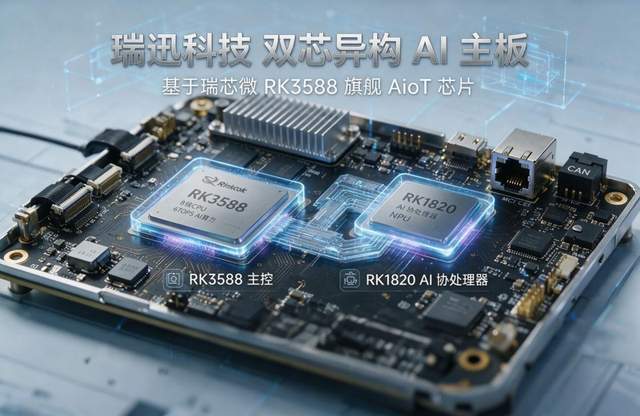
VLA推理的长时计算被隔离在协处理器域内,主控SoC上的控制线程不再需要等待推理队列的排队结果。控制回路的时间轴由主控自身维持,推理的延迟波动不会直接写进关节的力矩周期。
在这一架构中,主控SoC仍然可以运行ROS 2节点调度、多传感器融合和路径规划,但其NPU不再被大模型推理长期占用,CPU的调度抖动也不再被推理负载放大。协处理器RK182X则集中处理VLA推理和多模态任务,其算力规格20TOPS 针对大模型和视觉-语言任务优化。两者之间的数据交换通过PCIe完成,推理结果以动作意图或结构化指令的形式传递给主控,由主控转化为确定性的控制输出。
分级配置:不同“身体”需要匹配不同量级的时间约束
“大脑与身体的延迟矛盾”在不同机器人品类中的严重程度并不相同。磁条导航AGV对推理延迟的容忍度较高,一台人形灵巧操作机器人则几乎没有容忍空间。瑞迅科技基于RK3568、RK3576、RK3588三大机器人核心板平台的分级方案,对应的正是这种时间约束的梯度。
RK3568核心板面向以基础控制和轻量推理为核心的设备。四核架构和1TOPS NPU,推理负载本身较轻,单芯片内的资源争抢相对可控,适合固定路线AGV和轻量巡检设备。对于这类场景,控制周期的确定性可以通过PREEMPT-RT实时内核和EtherCAT协议在主控内部得到保障,不需要额外分离推理域。
RK3576核心板是中等时间约束场景的主力。六核CPU和6TOPS NPU可承载中等复杂度的视觉推理,功耗控制在4.5至5W,适合中端AMR、服务机器人和对续航敏感的移动平台。当这类设备开始引入轻量VLA或端侧语言模型时,RK3576配合RK182X协处理器可以将推理负载从主控中分离,避免推理延迟侵蚀导航和运动的控制周期。
RK3588安卓主板面向时间约束最紧、推理负载最重的品类。八核异构架构和三核6TOPS NPU本身具备较强的推理能力,但在人形机器人、高端协作机器人和灵巧操作场景中,仅靠主控NPU承载VLA推理仍会与控制任务争抢时间资源。此时RK3588与RK182X的双芯配置成为更匹配的选择:主控专注于运动控制、安全回路和多传感器同步,协处理器专职VLA和视觉推理,两者通过PCIe互联,让“20Hz的思考”和“1kHz的执行”各自运行在独立的时间通道上。
结语
机器人“大脑”的算力竞赛不会停下来,1500 TOPS的控制器也不会是终点。但算力数字本身并不解决物理世界的时序问题。一台机器人的运动稳定性,取决于推理结果能否在控制周期允许的时间窗口内到达执行端,而不是取决于模型在离线基准上跑得有多快。
VLA推理的50至200毫秒与控制环的1毫秒之间的错配,是具身系统内在的时间约束。解耦推理与控制的时间轴,让慢模型以低频产出意图、快控制器以高频执行,是行业正在收敛的工程路径。瑞迅科技以RK3588、RK3576、RK3568三大机器人核心板平台配合RK182X协处理器的双芯与分级方案,从硬件层面为这种时间隔离提供了可配置的载体。大脑可以继续变大,但身体需要始终运行在自己确定的时间轴上。
审核编辑 黄宇