 域财网
机器人VLA动作策略大模型如何在端侧部署?瑞迅科技RK3588/3576双芯架构打造硬件底座
一、VLA模型端侧部署的算力瓶颈
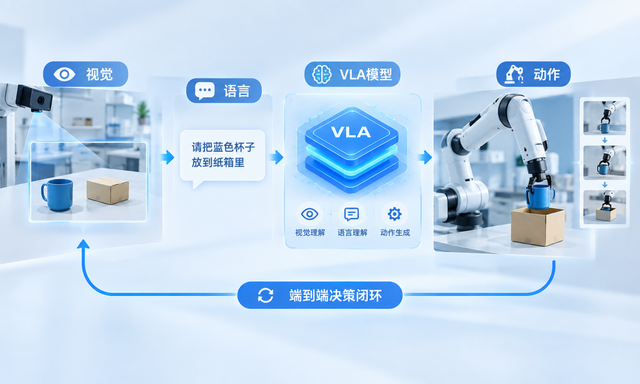
视觉-语言-动作(VLA)模型正在成为机器人智能化的重要技术路线。与传统视觉模型仅输出识别结果不同,VLA模型可以直接将自然语言指令转化为机器人的动作序列——机器人看到画面、理解指令、输出关节动作,形成一个完整的端到端决策闭环。
但VLA模型的端侧部署面临一个硬性约束。RT-2(55B参数)推理延迟高达330-1000毫秒,实时控制频率不到3Hz;OpenVLA(7B参数)单帧推理约166毫秒,需要8-15GB显存。单次VLA推理耗时为0.1-0.3秒,这对需要实时响应的工业机器人和协作机器人构成了较为明显的算力瓶颈。VLA推理的控制频率通常需要达到5Hz以上才能满足基本机器人控制需求。
上海交通大学的研究进一步揭示了VLA推理的独特计算特征:推理过程呈现明显的两阶段模式——先是计算密集的VLM骨干网络,然后是内存密集的Action Expert,这种模式导致硬件在前后两个阶段出现利用率不均的问题。这意味着VLA对主控硬件的需求不能仅看NPU算力(TOPS)这一个指标,内存带宽同样关键。
二、模型压缩:从大模型到端侧可部署
要让VLA模型在端侧跑起来,模型压缩是必经之路。当前主流技术路径包括量化、知识蒸馏、结构化剪枝和动作头轻量化。
量化是最直接的手段。将32位浮点参数映射到INT8或INT4精度,模型内存占用可降低约70%,推理速度显著提升,而精度损失在可接受范围内。知识蒸馏则将大VLA模型的知识迁移到参数更小的学生模型。例如从7B参数的OpenVLA蒸馏至1B参数的MiniVLA,性能反而有所提升。结构化剪枝围绕“视觉编码器—语言主干—动作解码器”三段式架构,剪除冗余的连接和通道。
在实际部署中,SmolVLA(210M参数)和TinyVLA(100M参数)等轻量级模型已能在Jetson Orin Nano等边缘平台上实现实时推理,推理延迟在140-260毫秒之间。这些压缩后的VLA模型为端侧部署提供了可行性基础,但要达到工业级的实时性和稳定性,仍需要合适的主控硬件平台支撑。
三、瑞迅科技双芯方案:VLA端侧部署的硬件路径
瑞迅科技推出的RK3588/RK3576主控+RK182X端侧AI协处理器双芯协同方案,为VLA模型端侧部署提供了一条可落地的硬件路径。
该方案的核心逻辑是将计算任务按类型分配到不同的处理器单元。RK3588作为主控SoC,采用八核异构架构(四核Cortex-A76+四核Cortex-A55),内置三核架构6TOPS NPU算力,负责运动控制、多传感器融合与系统调度;RK182X协处理器专职AI推理,两者通过PCIe高速互联,互不抢占资源。
针对VLA模型推理过程中“计算密集+内存密集”两阶段交替的特征,这种双芯架构具有天然适配性。VLA的VLM骨干网络运行在RK3588的NPU上完成视觉与语言理解;Action Expert的内存密集阶段可交由RK182X协处理器处理,其采用3D堆叠封装集成高带宽DRAM,有效缓解了内存带宽瓶颈。两者通过PCIe高速互联实现数据低延迟交换,避免单芯片方案中算力争抢和内存带宽不足的问题。
四、端侧AI推理与实时控制的协同
VLA模型端侧部署的另一大挑战,是如何让AI推理与运动控制在同一平台上并行运行且互不干扰。
工业机器人和协作机器人的运动控制要求控制周期通常小于1毫秒,抖动控制在微秒级。而VLA推理的耗时通常在百毫秒级别,两者在时间尺度上差异巨大。如果采用“全量输入-等待输出-执行动作”的同步模式,机器人就会出现明显的动作卡顿。
瑞迅科技驱控一体技术方案通过多核异构架构,将Linux控制与实时驱动合于一个处理器平台。主系统运行轨迹规划、逆运动学、机械臂模型计算等非实时任务;RT核心运行实时控制,负责低延时闭环。SoC与FPGA通过高速总线互联,FPGA承担PWM、AD、编码器、Safety信号的硬件级直接驱动,删减掉传统的独立驱动板,实现高集成度与低成本的统一平台。
在这种架构下,VLA推理可以运行在非实时域,负责生成高层动作规划;RT核心负责将动作规划转化为微秒级实时控制指令,两者通过共享内存或高速总线交换数据,确保AI推理的延迟不会传递到运动控制环节。
五、瑞迅科技分级方案:匹配不同VLA部署场景
VLA模型的参数量差异显著,从210M的SmolVLA到7B的OpenVLA,对主控硬件的需求跨越多个量级。瑞迅科技基于RK3568、RK3576、RK3588三大平台构建了分级化的嵌入式工控主板方案,客户可根据VLA模型的参数量、推理帧率和实时性要求精准选型。
RK3568平台采用四核Cortex-A55架构,内置1TOPS NPU算力,功耗控制在3.5W以内。适用于超轻量级VLA模型(100M-300M参数)的端侧部署,可支撑TinyVLA、SmolVLA等压缩模型在本地完成基础动作生成任务,是成本敏感型项目的经济之选。
RK3576平台搭载六核CPU架构(双核Cortex-A72+四核Cortex-A53),内置6TOPS NPU算力,支持多路MIPI-CSI摄像头并发接入。可支撑1B-3B参数级别的VLA模型端侧部署,适用于需要视觉引导与动作生成协同的中端工业机器人和协作机器人场景。
RK3588平台采用旗舰级八核异构架构,内置三核架构6TOPS NPU算力。单芯片可支撑2B-4B参数VLA模型的推理任务。配合RK182X端侧AI协处理器,整机算力可扩展至20TOPS以上,支撑7B参数级别VLA模型的端侧流畅运行,适用于人形机器人、高端协作机器人等复杂操作场景。
结语
VLA动作策略大模型的端侧部署,核心挑战在于算力、内存带宽和实时控制的协同。模型压缩技术正在降低VLA的部署门槛,而双芯协同架构则为大参数VLA模型的端侧运行提供了可行的硬件路径。
瑞迅科技以RK3568、RK3576、RK3588三大平台配合RK182X端侧AI协处理器的灵活扩展能力,为不同参数规模的VLA模型端侧部署提供了分级化的硬件方案。从超轻量级动作策略到9B参数级别的端到端决策,从工业机器人的精密装配到协作机器人的人机协同,都能在瑞迅科技的产品矩阵中找到匹配的嵌入式工控主板底座。
审核编辑 黄宇